دع تطبيقاتك تتحدث، وتفهم عملائك
تدمج SintelSES ميزات تحويل النص إلى صوت (TTS) وتحويل الكلام إلى نص (STT) على منصة واحدة. وتوفر بنية مرنة لمختلف الاحتياجات، من الإشعارات الصوتية إلى تطبيقات مراكز الاتصال، وتحليل التسجيلات، والتعرف على المحادثة الحية.
بفضل نماذج الصوت الموجهة للغة التركية وخيارات متعددة اللغات، تمكن مؤسستك من تطوير حلول مناسبة للغتك، وسيناريو الاستخدام، والبنية التحتية التقنية.
شغلها على بيئة افتراضية بدون الحاجة إلى GPU
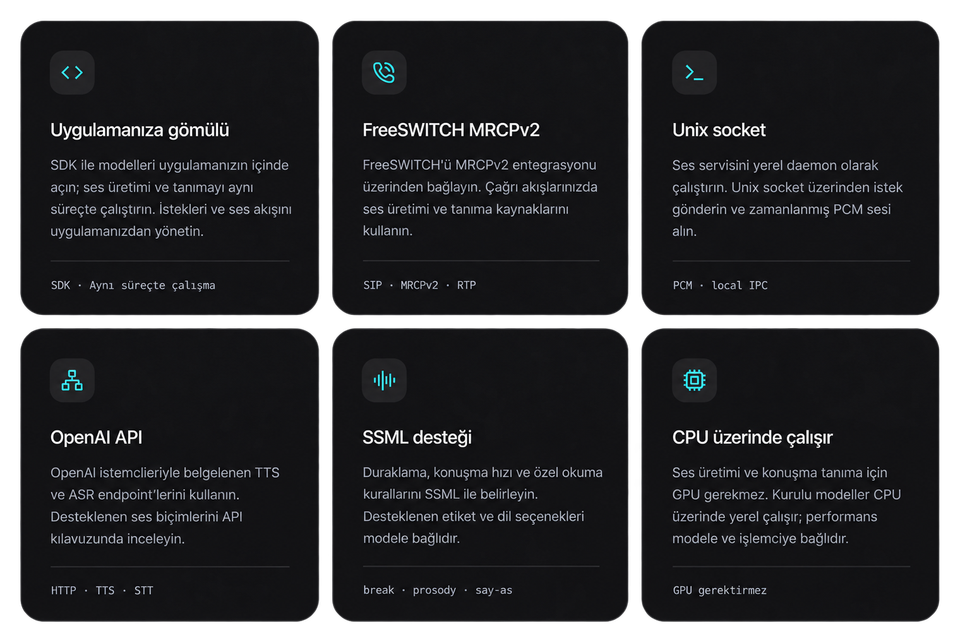
تقوم SintelSES بتنفيذ عمليات إنتاج الصوت والتعرف على الكلام على وحدة المعالجة المركزية (CPU). ويمكن استخدامها على بيئات الأجهزة الافتراضية المتوافقة دون الحاجة إلى GPU مخصص أو تكوين GPU passthrough. وبالتالي، يمكنك الاستفادة من البنية التحتية الافتراضية الحالية لديك لإطلاقها.
تُخطط موارد المعالج والذاكرة حسب النماذج المختارة، وعدد المعالجات المتزامنة، ومدة الاستجابة المستهدفة.
حول تحويل النص إلى صوت
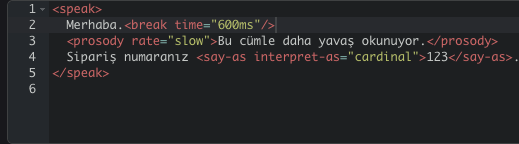
قم بتحويل رسائل الترحيب، والإعلانات، والإشعارات، ومحتوى التطبيقات إلى صوت. اختر الصوت المناسب من بين الخيارات الجاهزة، وضبط سرعة الكلام وطريقة القراءة في النماذج المدعومة.
- إنتاج صوت متعدد اللغات والتركية
- نماذج وخيارات صوت متنوعة لتلبية مختلف الاحتياجات
- إنتاج صوتي متدفق
- مع نماذج تدعم SSML مع توقفات، سرعة، وتحكم خاص في القراءة
حول تحويل المحادثات إلى نص
حوّل ملفات الصوت ومدخلات الميكروفون إلى محتوى مكتوب. وتابع وتحليل المحادثة أثناء التشغيل المباشر باستخدام النماذج المدعومة؛ وقيّم النص المستخلص ضمن عملياتك.
- استخراج النص من ملفات الصوت
- التعرف على الكلام عبر الميكروفون
- نتائج النصوص الوسيطية والنهائية في الوقت الحقيقي مع نماذج الدعم
- التعرف على اللغة التركية، واللغات المتعددة، وتحديد اللغة تلقائياً حسب النموذج المختار
دع بيانات الصوت الخاصة بك تعمل على بنيتك الخاصة
تقوم SintelSES بمعالجة إنتاج الصوت والتعرف على الكلام بشكل محلي. بعد إعداد النماذج، لا يلزم الاتصال بالإنترنت أو استخدام خدمات السحابة الخارجية لهذه العمليات.
من خلال تشغيلها على خوادمك الخاصة، يمكنك السيطرة على معالجة بيانات الصوت وتقليل الاعتماد على الخدمات الخارجية. وتقدم خيارات تثبيت بدون الحاجة إلى GPU بفضل عملها على وحدة المعالجة المركزية.
دمجها مع أنظمتك الحالية
يمكنك استخدام SintelSES كخدمة مستقلة أو دمجها ضمن تطبيقات Go عبر SDK.
- أنظمة الهاتف ومراكز الاتصال: تكامل مع FreeSWITCH عبر MRCPv2
- تطبيقات الويب والأعمال: دمج مع واجهات برمجة التطبيقات الصوتية المتوافقة مع OpenAI
- التعرف على الكلام في الوقت الحقيقي: نقل الصوت عبر WebSocket ونتائج النص
- التطبيقات المحلية: اتصال بالخدمة عبر Unix socket
- مشاريع Go: SDK مستقل يمكن تضمينه داخل التطبيق
يمكنك عبر الواجهة الويب نطق النصوص، وتحويل ملفات الصوت أو مدخلات الميكروفون إلى نص، وتجربة النماذج لديك.
أين تستخدم؟
- مراكز الاتصال و IVR: الترحيب الديناميكي، التوجيه، والرسائل الإعلامية
- الإشعارات المؤسسية: قراءة الإعلانات النصية صوتياً
- تحليل التسجيلات: تحويل المحتوى الصوتي إلى نص قابل للبحث والتعديل
- الخدمات الرقمية: إضافة ميزات الإدخال الصوتي والمحتوى الصوتي للتطبيقات
- الاتصال متعدد اللغات: سيناريوهات القراءة والتعرف على الكلام بعدة لغات
تختلف خصائص اللغة، والصوت، والتدفق حسب النموذج المُختار ونطاق التثبيت.
دعنا نحدد معًا الحل الصوتي المناسب لمؤسستك
تواصل معنا لتقييم نماذج التناسب، والإعداد، وخيارات التكامل المناسبة لاحتياجك.